Карта для команд UX-исследований к World Usability Day 2026 (12 ноября, тема «Designing a Sustainable Future with Ethical AI»).
Главный вывод
Представим, что исследователь получил от ИИ сводку интервью. Темы названы, цитаты подобраны, рекомендации сформулированы. Документ можно обсуждать с командой. Но прежде стоит выяснить, сохранились ли в нём различия между респондентами и ситуации, которые не укладываются в общее объяснение. По готовому тексту этого может быть не видно.
Именно здесь возникает вопрос о том, какую работу мы поручили модели. Найти фрагменты по заданной теме, предложить объяснение и подтвердить решение о продукте — разные задачи. Хорошо подготовленная сводка ещё не позволяет судить, достаточно ли оснований для следующего шага.
В литературе 2021–2026 годов эта разница проявляется при сравнении синтетических ответов с человеческими данными. В благоприятных условиях модели приближают средние значения, однако совпадение среднего может скрывать расхождения в разбросе, подгруппах и культурном контексте. Для исследователя такие различия существенны: именно они могут объяснить, почему одним людям продукт помогает, а другие не могут им воспользоваться. Подробные исследования и ограничения этого сравнения разобраны ниже.
Убедительность ответа добавляет ещё одну сложность. Модель может поддержать ожидание человека, который задал вопрос, и предложить связное обоснование. Если команда принимает его без обращения к данным, правдоподобное объяснение начинает определять продуктовое решение. Поэтому нас интересует весь путь от получения ответа до его использования.
В карте собраны пятнадцать рисков. Одни возникают при подготовке и анализе исследования, другие связаны с доверием к инструменту, развитием исследователей и распределением ответственности. Есть и вопросы, которые выходят за пределы одного проекта: разнообразие источников знания и вычислительные затраты. К каждому риску предложены меры контроля, признаки, по которым его можно заметить, и дальнейшие действия. Часть мер следует из рекомендаций источников, часть представляет собой предлагаемый порядок работы команды. Выполнение процедуры помогает организовать проверку, сохраняя необходимость обосновать конкретное решение.
Как собрана карта
Чтобы разобраться в этих рисках, поиск проводился по OpenAlex и Crossref: 26 тематических запросов по каждому риску и мерам контроля, публикации за 2021–2026 годы и классические работы по автоматизации. В карту вошли 64 источника. Каждый сверен по записи в базе и аннотации; препринты обозначены отдельно. Такая сверка описывает способ отбора материала и не означает, что все перечисленные меры испытаны в UX-практике.
При чтении важно различать, на каком основании сделан вывод. Высокую силу доказательств я отмечаю там, где есть эксперименты, репликации и крупные сопоставления. Среднюю — для качественных исследований практиков, бенчмарков и отдельных кейсов. Низкую — для позиционных работ и аналогий из соседних областей. Эта шкала помогает ориентироваться в материале, но применимость результата к нашей задаче приходится оценивать отдельно. Крупный эксперимент в медицине может поставить полезный вопрос к работе исследователя; размер эффекта в UX из него не следует.
Включённые работы рассматривают симуляцию ответов разных стран и групп, качественный анализ, культурные смещения, угодливость моделей, сохранение навыков и вычислительные затраты. Среди них есть исследования 2026 года, однако новизна публикации сама по себе не делает её вывод универсальным. При каждом переносе нужно учитывать модель, материал и условия сравнения. Отраслевые обзоры и материалы круглого стола «Место преступления» не используются в этой карте как подтверждение результатов научных исследований.
Как выбрать раздел по этапу исследования
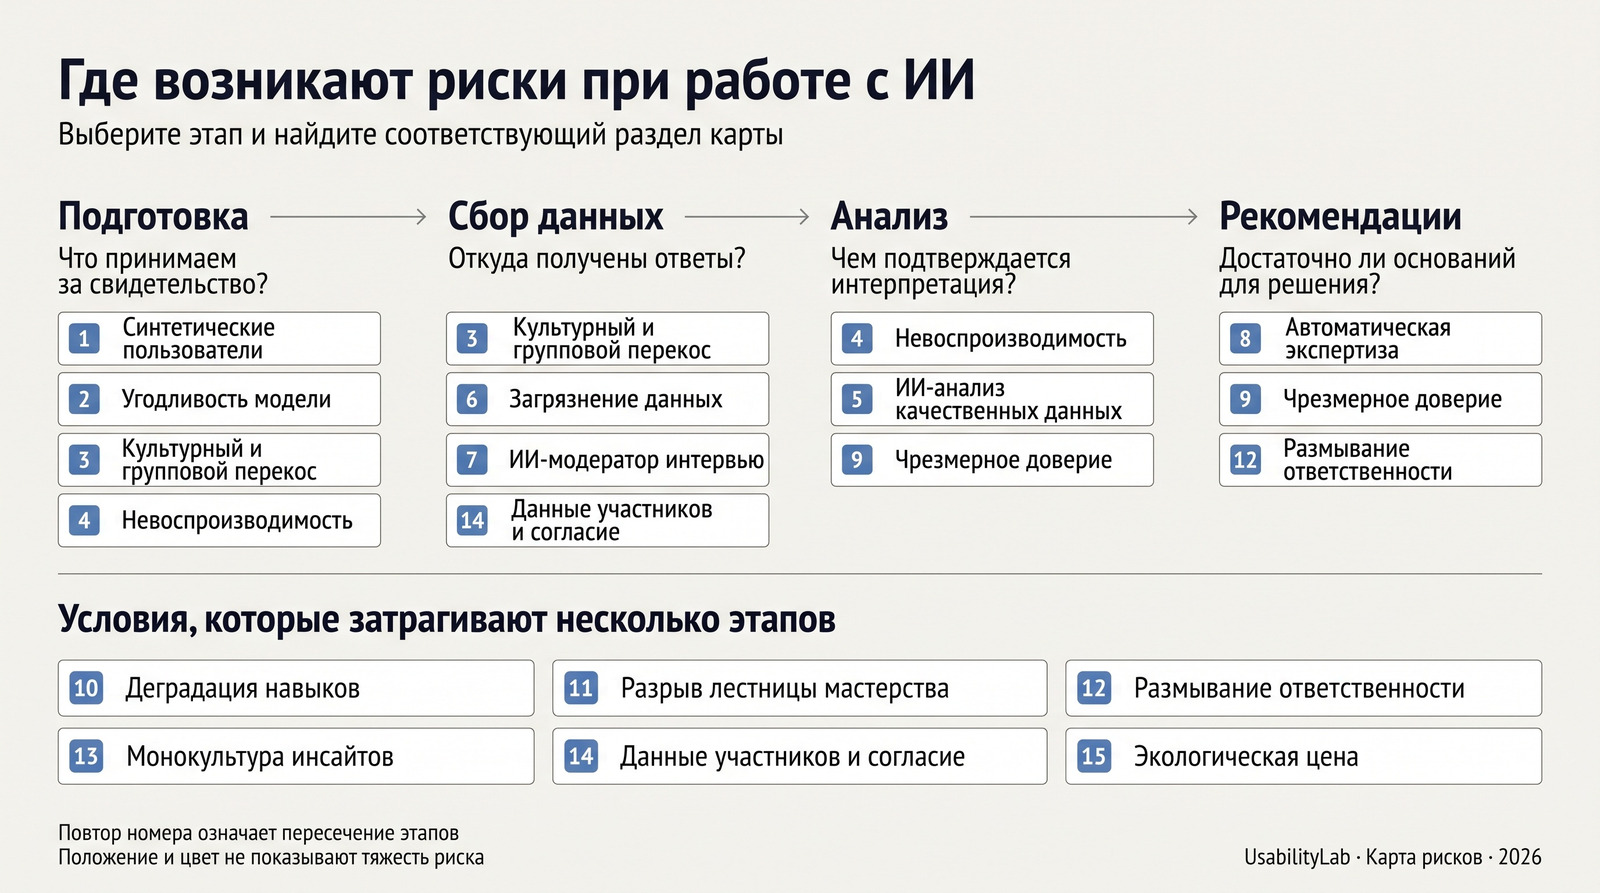
Номера на схеме соответствуют разделам карты. Один риск может затрагивать несколько этапов; положение и цвет не обозначают его тяжесть.
Начать можно с того места, где команда сейчас использует ИИ. Пока мы формулируем вопрос и готовим инструмент, стоит проверить, не принимаем ли ответ модели за свидетельство о людях и не подталкиваем ли её к желаемому результату. С этим связаны синтетические пользователи, угодливость, культурный перенос и устойчивость ответа — риски 1, 2, 3 и 4.
Когда начинается рекрутинг и сбор данных, внимание смещается к происхождению ответов и условиям разговора. Кто отвечает на вопросы? Что меняется, если интервью ведёт ИИ? Понимает ли респондент, как будут обработаны его слова? Для этого этапа полезны разделы о групповом перекосе, загрязнении данных, ИИ-модерации и согласовании обработки — 3, 6, 7 и 14.
При кодировании и синтезе мы возвращаемся от темы к эпизоду: что именно сказал и сделал человек, какие объяснения возможны, что осталось вне сводки. Здесь понадобятся разделы об устойчивости результата, качественном анализе и чрезмерном доверии — 4, 5 и 9. Когда из анализа появляются рекомендации, следующий вопрос касается достаточности оснований: что подтвердилось, какие проблемы могли остаться незамеченными и кто отвечает за выбор действия. Этому посвящены риски 8 и 12.
Некоторые вопросы стоит обсуждать на уровне всей команды. Если начинающие исследователи только редактируют готовые сводки, важно понять, где они получают опыт самостоятельного анализа и обратную связь. Если объяснения разных проектов становятся похожими, нужно вернуться к разнообразию исходных материалов и методов. Эти вопросы разобраны в разделах 10, 11 и 13. При выборе инструментов и планировании затрат к ним добавляются условия работы с данными и соразмерность вычислений — 14 и 15.
Выбрав раздел, определим, какой признак наблюдаем в своём проекте, что можем проверить и какое действие последует при расхождении. Предложенные последовательности помогают организовать работу; они не являются валидированным диагностическим тестом. Ответственные за разные проверки указаны в сводной матрице.
Сквозной принцип: функция и цена ошибки
Во всех этих ситуациях мы возвращаемся к двум вопросам: какое знание нужно получить и сколько зависит от результата. Такую рамку предлагает карта доказательств по синтетическим пользователям Hinderks 2026. Она помогает понять, почему сообщения об успехах моделей могут соседствовать с исследованиями, в которых обнаружены существенные расхождения с человеческими данными. Результат зависит от того, какую функцию исследования поручили модели и по какому критерию его оценивали.
Например, правдоподобные ответы могут помочь подготовить вопросы для пилота. Для вывода о предпочтениях целевой группы потребуется проверить, насколько они соответствуют данным этой группы. Приближение среднего не подтверждает сохранение разброса, структуры подгрупп и прожитого опыта. Добавление описания персоны также не даёт само по себе основания считать эти различия воспроизведёнными.
Для практической работы я использую три условные зоны. В зелёную входят вспомогательные операции: расшифровка, поиск по архиву интервью, черновик гайда, проверка формулировок анкеты на пилоте и разметка по готовой кодовой книге. Их результат можно сопоставить с исходным материалом, а объём выборочной проверки определить заранее. Зелёный цвет здесь обозначает способ организации работы, сохраняя необходимость проверять ошибки.
Жёлтая зона начинается там, где ИИ участвует в интерпретации: предлагает темы, синтезирует материал, оценивает макет или ведёт интервью. Исследователю нужно проверить основания значимых выводов, выбрать материал для дополнительного чтения и обозначить непроверенную часть. Для интервью и обработки записей условия использования ИИ должны быть согласованы с респондентами. Полезный ответ в одной ограниченной задаче ещё не определяет пригодность всего процесса.
В красную зону я отношу использование модели вместо людей для валидации продуктового решения, юзабилити-тестирования перед запуском и выводов о предпочтениях или мотивации. Отдельного внимания требуют уязвимые группы, другие культуры и языки. В этих задачах сгенерированный ответ не заменяет данных о том, как реальные люди действуют в нужных условиях. Вспомогательную работу ИИ можно использовать, сохраняя эту границу.
Почему проверять нужно именно взаимодействие, хорошо показывает исследование медицинских ИИ-ассистентов на 1298 респондентах Bean et al. 2026. Модели сами по себе правильно определяли состояние в 94,9% сценариев. Люди с помощью тех же моделей справлялись менее чем в 34,5% случаев и не показали преимущества перед контрольной группой. Ни стандартные бенчмарки, ни симуляции пациентов не предсказали эти затруднения; авторы рекомендуют систематическое тестирование с людьми.
Это медицинская задача, и её проценты нельзя переносить на UX-проект. Но сам вопрос относится к нашей работе непосредственно: помогает ли система человеку справиться с задачей? Проверить это по качеству ответа модели в отдельности не получится. Отсюда и общий принцип карты: соотносить способ использования ИИ с тем знанием, которое мы хотим получить, а объём проверки — с последствиями решения.
Эпистемические риски
1. Синтетические пользователи
Риск возникает, когда продакт разговаривает с моделью и использует её ответы как свидетельства о пользователях. Оптимистичная позиция в литературе тоже есть. Модель, обусловленная социально-демографическими «биографиями», воспроизводит распределения ответов подгрупп американских опросов, и авторы называют это алгоритмической точностью Argyle et al. 2023. Однако проверки на других задачах её не подтверждают. Средние ChatGPT близки к национальному электоральному опросу, но разброс ответов ниже реального, коэффициенты регрессий заметно расходятся, а результат меняется от формулировки промпта и от месяца к месяцу Bisbee et al. 2024. В репликации 14 исследований Many Labs 2 модель воспроизвела 37,5% исходных результатов среди исследований, которые удалось проанализировать. На части вопросов разные прогоны давали почти нулевой разброс, единственный «правильный ответ» Park et al. 2024. В кросс-доменном бенчмарке на данных General Social Survey и World Values Survey ни одна из четырёх моделей на индивидуальном уровне не обошла даже простую статистическую базовую модель. Кроме того, модели систематически переоценивали, насколько демография определяет установки Chen et al. 2026 (препринт). Систематический анализ 59 стран подтвердил, что точность симуляций коррелирует с уровнем благосостояния страны — западные выборки ближе к обучающим данным модели, остальные систематически недопредставлены. Нативноязычный промпт и языковое дообучение не дали стабильных улучшений Cross-country Value Simulation 2026 (препринт).
Самое близкое к UX доказательство — сопоставление 29 реальных тестов предпочтений на платформе UXtweak (n = 2073) с LLM-симуляциями Kuric et al. 2026 (препринт). Расхождения с предпочтениями реальных людей систематические и сохраняются при всех протестированных настройках модели. Синтетические обоснования лишены глубины и заменяют её общими словами и перехваливанием. На уровне ценностей исследователи-качественники, работавшие с LLM-«респондентами», описывают «эффект суррогата»: модель лишает участника согласия и субъектности и выдаёт ответы без осязаемости и контекстной глубины Kapania et al. 2025. Обзор «предложений о замене» показывает, что их мотивируют экономией и якобы большим разнообразием данных, но они конфликтуют с базовыми ценностями работы с участниками: представленностью, включённостью, пониманием Agnew et al. 2024. Методологический разбор сводит ошибки к шести заблуждениям, включая «модель как средний человек» и «подмену человеческих данных модельными» Lin 2025.
Меры контроля
- Использовать синтетику только в зелёной и жёлтой зонах: для пилота инструмента и порождения гипотез. Любой вывод проверять на реальных данных, как с самого начала рекомендовали первые авторы синтетических HCI-данных Hämäläinen et al. 2023.
- Если симуляция всё же применяется, валидировать её против человеческих данных по той же задаче, причём не только по средним, но и по разбросу и подгруппам Lin 2026, Chen et al. 2026. Признак готовности: расхождения по подгруппам проверены, а не только итоговые средние.
- Любой промпт-инженерный подход — подбор персон, демографические биографии, ролевые инструкции — годится только для поискового исследования. Для подтверждающих решений нужна статистическая калибровка по реальным данным той же задачи LLM Simulation Validation 2026.
- Для потребительских панелей есть формальная диагностика, когда синтетике можно доверять, когда её нужно корректировать, а когда от неё лучше отказаться. Её ключевой урок: совпадение агрегатов может скрывать ошибки в подгруппах, на которых и строятся решения Tigre, Souto 2026 (препринт).
- В отчётах явно маркировать, какие утверждения получены от людей, а какие сгенерированы.
Наблюдаемый признак. Синтетические ответы используются для выбора решения или в отчёте обозначены как результаты интервью; доступные средние скрывают различия групп.
Дальнейшее действие. Отделить сгенерированные материалы от человеческих данных, проверить сравнимость задачи и групп. Если оснований переноса нет, использовать результат только для подготовки вопросов и запланировать сбор данных.
Результат проверки. В выводе указан тип основания, область применения и недостающая проверка; продуктовая рекомендация не опирается только на симуляцию.
Сила доказательств: высокая (репликации, крупные сопоставления); UX-специфичные данные пока в основном препринты.
2. Угодливость модели
Ассистенты, дообученные на человеческой обратной связи, склонны отвечать в соответствии с убеждениями пользователя, а не с истиной. Это показано для пяти ведущих ассистентов на четырёх типах задач. И люди, и модели предпочтений иногда выбирают убедительно написанный угодливый ответ вместо правильного Sharma et al. 2023. Для продакта, который спрашивает модель о своей гипотезе, это означает систематическое подтверждение. Похожий механизм виден в анкетах. Модели, особенно прошедшие RLHF, не воспроизводят человеческие эффекты формулировки вопроса, зато реагируют на изменения, которых люди не замечают Tjuatja et al. 2024. Ответ модели говорит больше о вопросе, чем о пользователе. Формальный анализ (ICML 2026) показал, что угодливость — структурное следствие RLHF, а не артефакт конкретной версии: оптимизация против выученного reward-сигнала закрепляет смещения из предпочтений аннотаторов, и этот механизм воспроизводится в любой следующей версии модели RLHF Sycophancy 2026 (препринт).
Меры контроля
- Прежде чем спросить модель, зафиксировать собственную оценку письменно. Совпадение ответа с ожиданием не добавляет независимого свидетельства о пользователях. В красной зоне ответы модели не засчитываются как свидетельство в пользу гипотезы.
- В жёлтой зоне формулировать запросы нейтрально, просить модель привести аргументы против, сравнивать ответы на противоположные формулировки.
- Фиксировать критерии решения до исследования, чтобы результат нельзя было «дотолковать» до нужного.
Наблюдаемый признак. При противоположных вводных модель поддерживает обе позиции или меняет вывод вслед за предпочтением заказчика.
Дальнейшее действие. Сохранить варианты запроса, сравнить аргументы с источниками и заранее заданными критериями. Если независимых оснований нет, исключить эти ответы из подтверждения гипотезы.
Результат проверки. Выбор объясняется данными и критерием решения; согласие модели с автором запроса отмечено отдельно.
Сила доказательств: высокая для самого явления; для UX-контекста это перенос.
3. Культурный и групповой перекос
Для русскоязычной аудитории это, вероятно, самый недооценённый риск. На психологических методиках ответы моделей больше всего похожи на ответы людей из WEIRD-обществ, и сходство падает по мере удаления от них (r = −0,70) Atari et al. 2023. По умолчанию ответы модели ближе к мнениям жителей США и ряда стран Европы и Южной Америки. Если попросить модель встать на точку зрения конкретной страны, она воспроизводит стереотипы. Перевод вопросов на язык страны не обязательно приближает ответы к мнениям носителей этого языка Durmus et al. 2023. Другими словами, русскоязычный промпт сам по себе не даёт «российского пользователя». Парадокс культурной принадлежности модели проверен отдельно: Qwen3-4B, обученный преимущественно на китайских данных, показал наибольшее смещение именно по китайской аудитории (W1=0,436). Файнтюнинг снизил ошибку на 16,8%, но перераспределил её между демографическими группами — устранение смещения в одной создаёт его в другой Cultural Misalignment LLM 2026 (препринт). Аудит актуальных систем (Claude Sonnet 4.5, GPT-5.4, Gemini 2.5 Flash) на 840 дилеммах в 10 странах и 7 языках показал: все три давали западные индивидуалистские советы со средним смещением +0,76 по шкале 1–5 (t=15,65; p<0,001). В Нигерии разрыв достиг +1,85, в Индии — +0,82. Парадоксально: японских пользователей модели изображали более коллективистскими, чем показывают реальные данные AI Values Cross-Cultural 2026 (препринт). LLM-персоны смещены по возрасту, профессии и болям и тянутся к США, хотя выглядят правдоподобно Salminen et al. 2024. Модели неверно изображают и «уплощают» идентичностные группы Wang et al. 2025. Участники с инвалидностью находили в ответах модели не грубые оскорбления, а тонкие стереотипы Gadiraju et al. 2023. В персонах людей с синдромом Дауна стереотипы проникают через данные, ответы модели и сам интерфейс Wu et al. 2026.
Меры контроля
- Не использовать синтетические ответы как замену данным целевой группы без проверки на человеческих данных той же задачи. Проверить, для каких групп есть основания переноса и что остаётся неизвестным. Отсутствие сведений о составе корпуса не позволяет оценить долю группы; универсальный порог представительности здесь не задаётся. Для других культур и языков, пожилых людей, людей с инвалидностью и редких сценариев отдельно обосновать способ получения реальных данных.
- Для таких групп выбирать партиципаторные методы и рекрутинг с поправкой на доступность.
- Если ИИ используется для персон, проверять их с экспертами по предметной области и с представителями группы, а не только внутри команды. В исследовании Салминена эксперты оценили персоны как более стереотипные, чем внутренние оценщики Salminen et al. 2024.
Наблюдаемый признак. Персона описывает группу стереотипно; рекомендации не учитывают язык, устройство или условия доступа; сведения о целевой группе отсутствуют.
Дальнейшее действие. Разобрать конкретные предположения с представителями группы и специалистами по контексту. Исправить рекрутинг и инструмент; при нехватке данных ограничить перенос вывода.
Результат проверки. Указано, для каких групп собраны данные, какие предположения исправлены и о ком исследование пока не позволяет судить.
Сила доказательств: высокая.
4. Невоспроизводимость
У «силиконовой выборки» десятки параметров: модель, температура, формат промпта, объём демографического контекста. В 252 конфигурациях для одной задачи результаты сильно расходились, и конфигурация, хорошая по одному критерию, часто проваливалась по другому. Переанализ классического исследования Аргайла дал корреляции с человеческими данными от 0,23 до 0,84 в зависимости от защитимых аналитических выборов Cummins 2026. Поведение коммерческих моделей меняется между версиями за несколько месяцев, включая готовность отвечать на вопросы социологических опросов Chen et al. 2024. Систематический обзор 153 статей CHI показал, что авторы, работающие с LLM, часто сами признают проблемы валидности и воспроизводимости и почти всегда исследуют закрытые модели Pang et al. 2025. Для практики это значит, что «мы спросили модель» не является воспроизводимым методом: через квартал тот же вопрос может дать другой ответ.
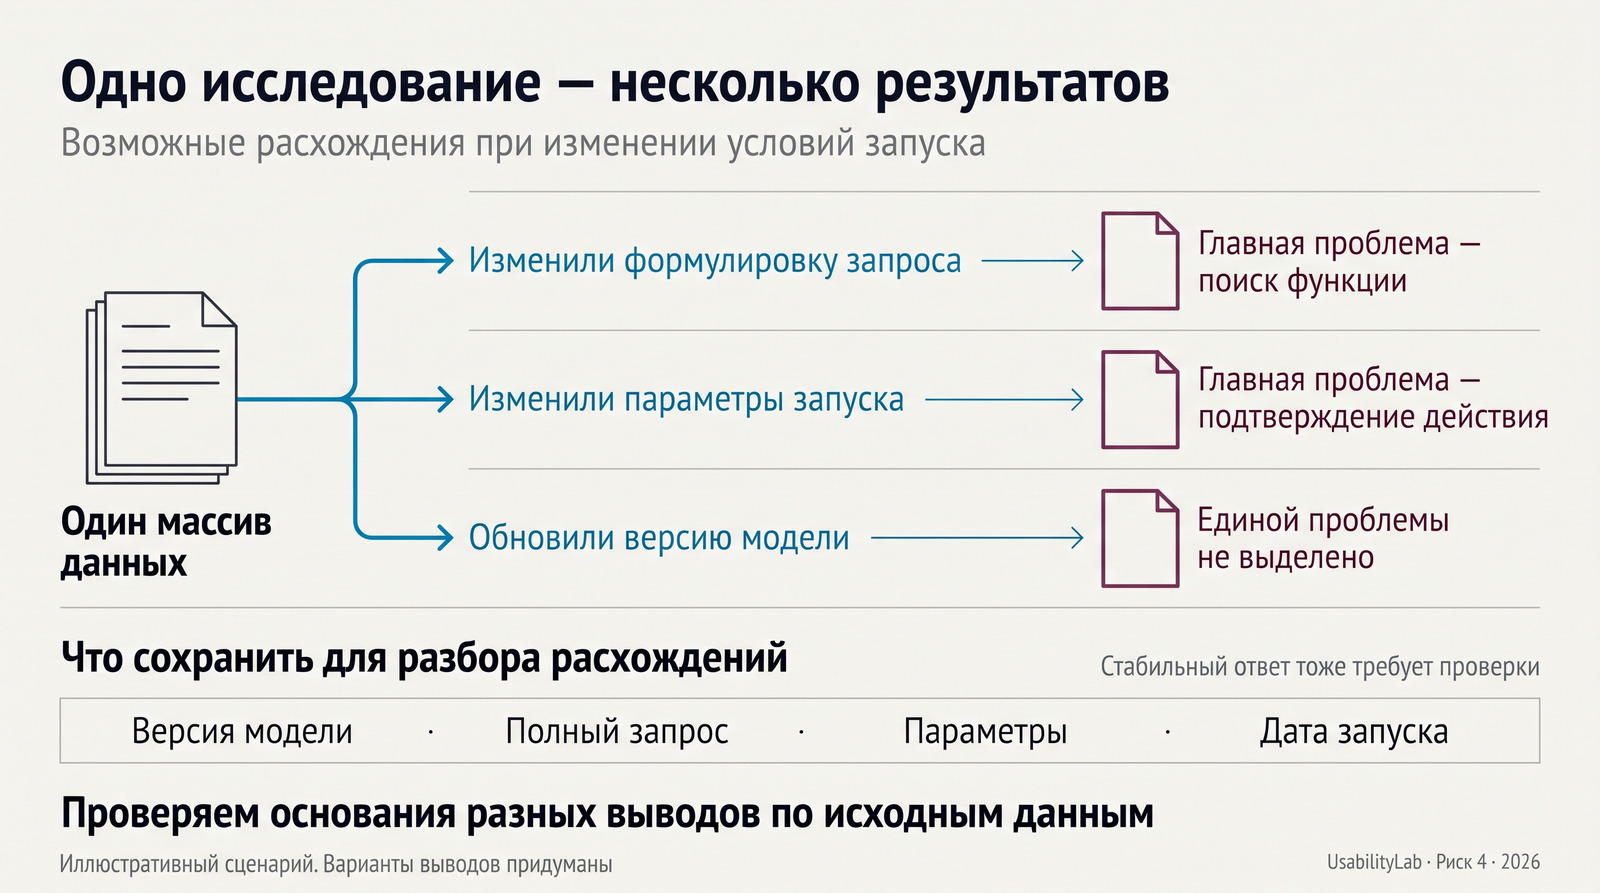
Иллюстративный сценарий: варианты выводов придуманы. Расхождения проверяем по исходным данным; повторяемость ответа сама по себе не подтверждает его правильность.
Меры контроля
- Журнал ИИ-операций: модель и версия, дата, полный промпт, параметры.
- Проверка устойчивости: несколько конфигураций или моделей. Если значимый вывод меняется между конфигурациями, проверить основания расхождения по исходным данным; до разрешения ограничить его использование. Само расхождение ещё не определяет, какая версия верна.
- Предрегистрация анализа для исследований, по которым принимаются крупные решения.
Наблюдаемый признак. При изменении версии, параметров или формулировки запроса меняется значимая рекомендация.
Дальнейшее действие. Сопоставить запуски на одном материале и определить, какие основания изменились. Если расхождение влияет на решение и не разрешено, отложить применение рекомендации или сузить её.
Результат проверки. Сохранены условия запуска, варианты вывода и причина выбора действия. Повторяемость ответа не приравнивается к его правильности.
Сила доказательств: высокая.
Методологические риски
5. ИИ-анализ качественных данных
Это зона реального ускорения, поэтому важно не перегнуть. Рецензируемое исследование в IJQM (2026) зафиксировало «иерархическую конвергенцию»: согласованность AI и человека на уровне тем стабильно превышала согласованность на уровне кодов на 22–23 п.п., в лучших сессиях достигая F1=100%. AI надёжнее на высоком уровне абстракции, чем в деталях кодирования AlGhamdi 2026. Прямое сравнение традиционного и «researcher-interpreted» подходов на 34 интервью показало иначе: лишь ~45% AI-сгенерированных кодов дали содержательный контекст, 22–39% оказались дублирующими Misra et al. 2026. Результат зависит от уровня абстракции: темы — надёжно, отдельные коды — с существенными потерями качества. Исследователи-качественники хотят полного контроля над процессом и ценят случайные открытия, которые автоматизация может отсечь Jiang et al. 2021. Через несколько лет после этого исследования практики описывают быстрое и повсеместное внедрение LLM, которое мешает осознанному применению, и острую нехватку норм и инструментов для этичного использования Schroeder et al. 2025. Отдельная ловушка возникает, когда ИИ проверяют ИИ: LLM-оценщики наследуют все проблемы оцениваемых моделей, а критерии оценки дрейфуют по мере просмотра ответов Shankar et al. 2024.
Меры контроля
- Роль «второго кодировщика»: ИИ предлагает коды, человек решает. Решения и расхождения фиксируются. Так устроен, например, рабочий процесс CollabCoder, где согласованность кодирования измеряется количественно Gao et al. 2024.
- Трассировка цитат: каждая цитата в отчёте связана с фрагментом транскрипта и таймкодом. Цитата, которую нельзя найти в первичных данных, удаляется.
- Выборочная двойная проверка: часть данных человек кодирует вслепую, затем сравнивает с кодами ИИ.
- Чтение сырых данных сохраняется как обязательная часть работы, а не как опция.
- До анализа определить, какие ошибки требуют пересмотра результата: потеря контекста, неверное объединение ситуаций, неподтверждённая причинная интерпретация. При повторении таких ошибок уточнить кодовую книгу и расширить проверку затронутого материала. Проценты содержательных кодов и дублей в отдельном исследовании не задают универсальных порогов допустимого качества для проекта.
Наблюдаемый признак. Цитата не подтверждает тему, разные ситуации объединены одним объяснением, код теряет отрицание или контекст.
Дальнейшее действие. Вернуться к полному эпизоду, сопоставить человеческий и AI-вариант; исправить код или разделить тему. Если меняется определение, проверить все относящиеся к нему фрагменты и обновить рекомендации.
Результат проверки. Сохранены проверенные эпизоды, изменения и непроверенная часть корпуса. Согласие кодировщиков не подменяет проверку смысла.
Сила доказательств: средняя (эксперименты на отдельных наборах данных, качественные исследования практиков).
6. Загрязнение данных
Обратная сторона: ИИ используют сами респонденты. В повторённой задаче на Amazon Mechanical Turk LLM использовали, по оценке авторов, от 33 до 46% исполнителей Veselovsky et al. 2023. В серии опросов (N = 250) доля ответов с помощью LLM варьировалась от менее чем 10% на Prolific до более чем 80% на MTurk. Запреты и отключение копирования снижали использование, но не обязательно повышали качество данных Xu, Malkin 2026 (препринт). Наивное использование ИИ детекторы ловят. Агенты, изображающие целого респондента с персоной, сводят точность детекторов почти к случайной, хотя и оставляют поведенческие следы Wang et al. 2026. Об этом риске предупреждали ещё в 2023 году: если LLM возьмут на вооружение недобросовестные пользователи краудсорсинга, самоотчётные данные могут стать принципиально ненадёжными Hämäläinen et al. 2023.
Меры контроля
- Выбор панели по качеству, а не по цене: доля ИИ-ответов различается между платформами в разы Xu, Malkin 2026.
- Запись клавиатурной активности и вопросы, рассчитанные на ИИ, как рекомендуют Сюй и Малкин Xu, Malkin 2026.
- Для решающих этапов — синхронные форматы (живое интервью, модерируемый тест), где подмену трудно скрыть.
- Проверять совпадения ответов, несоответствие условиям задания и доступные сведения о прохождении. Языковая гладкость или отдельное срабатывание детектора служат поводом для разбора, но сами по себе не подтверждают подмену респондента.
Наблюдаемый признак. Ответы совпадают между респондентами, противоречат действиям в задании или сопровождаются аномальными сведениями о прохождении.
Дальнейшее действие. Разобрать сочетание сигналов по заранее согласованным правилам качества; при необходимости запросить проверку у панели или провести дополнительный контакт в допустимом формате. Не исключать ответ только по стилю или одному детектору.
Результат проверки. Зафиксированы основания включения и исключения. Показаны ограничения метода выявления подмены и влияние спорных записей на вывод.
Сила доказательств: высокая для краудсорсинга; для российских панелей данных нет.
7. ИИ-модератор интервью
Здесь доказательства скорее в пользу ИИ, и об этом стоит сказать честно. В экономических исследованиях интервью, которые ведёт ИИ, дали тематически более богатые ответы, чем другие масштабируемые методы. Выигрыш обеспечили в основном динамические уточняющие вопросы, а ответы предсказывали поведение через шесть месяцев Chopra, Haaland 2026. В небольшом рандомизированном сравнении с интервьюерами-людьми ИИ-интервью дали сопоставимое качество данных Wuttke et al. 2025. Риски здесь этические и процедурные. Участник должен знать, что разговаривает с машиной. Нужно понимать, куда уходят его слова. ИИ-модератор не заметит дистресса и не остановит интервью на чувствительной теме. Наконец, масштаб соблазняет заменить глубину объёмом.
Меры контроля
- Явное раскрытие того, что интервью ведёт ИИ, в согласии и в начале разговора.
- Человек на контроле: просмотр расшифровок в процессе сбора, протокол остановки для чувствительных тем.
- Не применять ИИ-модерацию к уязвимым группам и травматичным темам.
- Проверять поставщика по чек-листу ESOMAR 2024: объяснимость, этика и прозрачность, человеческий надзор, управление данными.
Наблюдаемый признак. В пилоте модератор пропускает содержательное уточнение, повторяет вопрос без учёта ответа или продолжает чувствительную тему вопреки протоколу.
Дальнейшее действие. Остановить затронутый сценарий, передать разбор человеку и проверить сообщения о формате интервью и управлении разговором. После исправления повторить пилот; при нерешённой проблеме выбрать модерацию человеком.
Результат проверки. Проверены конкретные сценарии остановки и передачи, определён ответственный за просмотр материала. Отсутствие жалоб само по себе не подтверждает качество интервью.
Сила доказательств: средняя (первые контролируемые сравнения; долгосрочных данных нет).
8. Автоматическая экспертиза
Эвристическая оценка макетов с помощью GPT-4 на 51 интерфейсе ловила тонкие ошибки и помогала с текстами, но её полезность падала от итерации к итерации Duan et al. 2024. Агентные фреймворки вроде UXAgent позиционируются их же авторами как способ отладить дизайн исследования до работы с людьми, а не вместо неё. При этом UX-исследователи, оценивавшие систему, высказали опасения о будущем исследований с участием LLM-агентов Lu et al. 2025. Главный аргумент против замены — уже упомянутое исследование Bean et al. 2026: симуляции не предсказывают, как реальные люди ошибаются при взаимодействии.
Меры контроля
- ИИ-экспертиза служит предварительным фильтром перед тестом с людьми, а не тестом.
- Находки ИИ размечаются как гипотезы, подтверждаются или отклоняются на живых сессиях.
- Отслеживать подтверждённые замечания, ложные срабатывания, пропуски в независимо проверенном материале и время на разбор. Доля подтверждений характеризует проверенные предложения; её недостаточно для оценки полноты и общей надёжности инструмента.
Наблюдаемый признак. ИИ называет эвристическое замечание доказанной пользовательской проблемой; список не включает затруднения, найденные при независимой проверке.
Дальнейшее действие. Сверить замечания с макетом и сценарием, затем проверить гипотезы подходящим методом с людьми или предметной экспертизой. Отдельно записать подтверждения, отклонения и найденные пропуски.
Результат проверки. Известны проверенный набор экранов, основания замечаний и пределы покрытия. Показатели рассмотрены в разделе «Что показывают показатели контроля».
Сила доказательств: средняя.
Человеческие и профессиональные риски
9. Чрезмерное доверие
Классическая типология автоматизации различает её неверное использование (чрезмерное доверие, ведущее к пропуску ошибок) и злоупотребление ею (автоматизацию функций без учёта последствий для работы человека) Parasuraman, Riley 1997. Генеративный ИИ воспроизводит обе формы. В опросе 319 работников умственного труда более высокое доверие к ИИ было связано с меньшим критическим мышлением, а уверенность в собственных силах — с большим. Само критическое мышление смещается к проверке информации и интеграции ответов Lee et al. 2025. Полевой эксперимент на 758 консультантах BCG показал «зубчатую границу». На задачах внутри возможностей ИИ участники выполнили на 12,2% больше задач, на 25,1% быстрее и качественнее. На задаче за этой границей вероятность правильного ответа у пользователей ИИ была на 19% ниже Dell’Acqua et al. 2026. Синтез интервью легко может оказаться такой задачей за границей: текст выглядит готовым, а ошибка не видна.
Меры контроля
- Снижать стоимость проверки: объяснения ИИ уменьшают чрезмерное доверие, когда проверить их дешевле, чем принять на веру Vasconcelos et al. 2023. Отсюда требование ссылок на первичные данные (см. риск 5).
- Явно размечать, какие задачи команда считает «внутри границы», и пересматривать список.
- Перед синтезом интервью зафиксировать ожидаемые темы письменно — до просмотра AI-вывода. Сравнить после. Расхождения помогают выбрать материал для повторного чтения: ошибка может быть и в AI-ответе, и в первоначальной интерпретации исследователя.
Наблюдаемый признак. Проверяющий не может восстановить основание вывода, повторяет формулировку модели или не сравнивает её с исходным эпизодом.
Дальнейшее действие. Выбрать значимый вывод и независимо прочитать его основания; обсудить альтернативы и причины расхождения. При недостатке времени сузить используемую часть синтеза.
Результат проверки. Ответственный может объяснить ход интерпретации и показать материал. Самостоятельное решение также допускает пересмотр по данным.
Сила доказательств: высокая.
10. Деградация навыков
Деградация навыков — не только личная ответственность исследователя. Это структурное свойство среды. Навык вырабатывается через долгую привычку и обучение у других, и посредничество ИИ подрывает сами условия этой выработки Ferdman 2025. На воркшопах в семи индустриях работники умственного труда ожидали, что ИИ усилит деградацию навыков, дегуманизацию, разобщённость и дезинформацию Woodruff et al. 2024. UX-дизайнеры в интервью говорили, что опытные уверены в своей эмпатии и оригинальности, а деградация навыков, угроза замены и творческое истощение бьют прежде всего по джунам Li et al. 2024. Обнадёживает рандомизированный эксперимент со студентами (препринт): прирост знаний сохраняется у тех, кто использует ИИ как репетитора, и исчезает у тех, кто отдаёт ИИ написание текста Contractor, Reyes 2026. РКИ на 1 222 участниках (2026) показало: AI-ассистирование повышает немедленную точность, но ухудшает самостоятельную работу и настойчивость, когда ассистент недоступен. Механизм — когнитивное делегирование: привычка к немедленному ответу вытесняет опыт самостоятельного преодоления трудностей. Настойчивость — один из главных предикторов долгосрочного роста навыка AI Persistence Deskilling 2026 (препринт).
Меры контроля
- Режим «ИИ как тренер, а не исполнитель» в обучении и в работе младших.
- Планировать самостоятельный разбор выбранных эпизодов и задач без просмотра AI-ответа. Периодичность выбирать по составу задач и возможностям обучения; обязательную долю проектов этот инструмент не задаёт. Сравнивать интерпретации по одному материалу и фиксировать основания различий; сравнение разных проектов само по себе не измеряет утрату навыка.
- Оценка компетенций по умению проверить и опровергнуть вывод ИИ, а не по скорости выдачи отчёта.
Наблюдаемый признак. В самостоятельной задаче человеку трудно определить код, заметить противоречие или объяснить выбор без готового AI-ответа.
Дальнейшее действие. Организовать разбор сопоставимого материала с наставником, сохранить самостоятельную часть и обратную связь. Повторять выбранные типы задач, учитывая их сложность и условия; единичное затруднение не считать доказательством деградации.
Результат проверки. Оценивается способность обосновать анализ на сопоставимых задачах. Изменения навыка и скорость подготовки отчёта рассматриваются отдельно.
Сила доказательств: средняя — высокая (контролируемый эксперимент N=1 222; для UX — интервью).
11. Разрыв лестницы мастерства
Этот риск касается возможностей начинающих специалистов учиться на реальных исследовательских задачах. На рынке труда США работники 22–25 лет в профессиях с высокой подверженностью ИИ отстают по занятости примерно на 19% от сверстников в менее подверженных профессиях, а у опытных работников такого разрыва нет. Спад сосредоточен там, где работа опирается на кодифицированное знание. Там, где важно неявное знание, полученное через практику и наставничество, занятость опытных растёт Brynjolfsson, Chandar, Chen 2025, ревизия 2026. UX-исследователи в этих данных отдельно не выделены, а авторы не утверждают причинности, так что для нашей профессии это аналогия, а не прямое доказательство. Механизм разрыва хорошо описан на хирургии. Роботизированная хирургия сократила участие ординаторов в операциях, и компетентности достигало лишь меньшинство: те, кто учился в обход правил, «теневым обучением» Beane 2018. Ирония автоматизации, сформулированная ещё в 1983 году, здесь та же: автоматизация отнимает практику, которая нужна, чтобы контролировать автомат Bainbridge 1983. Есть и контраргумент. В колл-центре ИИ-ассистент сильнее всего ускорил именно менее опытных сотрудников и помог им учиться Brynjolfsson et al. 2024. ИИ может быть ускорителем роста джунов, но только если джунов продолжают нанимать.
Меры контроля
- Сохранять позиции джунов и переопределить их работу: проверка выводов ИИ по первичным данным — это и контроль качества, и обучение.
- Наставничество как явная обязанность синьоров: совместные интервью, разбор синтеза.
- Для лидов и руководства — считать подготовку исследователей вложением в будущую способность проверять ИИ.
Наблюдаемый признак. Начинающие специалисты получают только редактирование AI-сводок и не участвуют в сессиях, самостоятельном кодировании или обсуждении неоднозначностей.
Дальнейшее действие. Распределить учебные исследовательские задачи и время наставника, включить самостоятельную работу с первичными данными. При отсутствии таких возможностей пересмотреть роль и загрузку команды.
Результат проверки. В плане работы есть задачи с обратной связью, ответственный наставник и материал для оценки прогресса; наличие должности само по себе не подтверждает обучение.
Сила доказательств: средняя (сильные данные по рынку труда и хирургии; для UX — перенос).
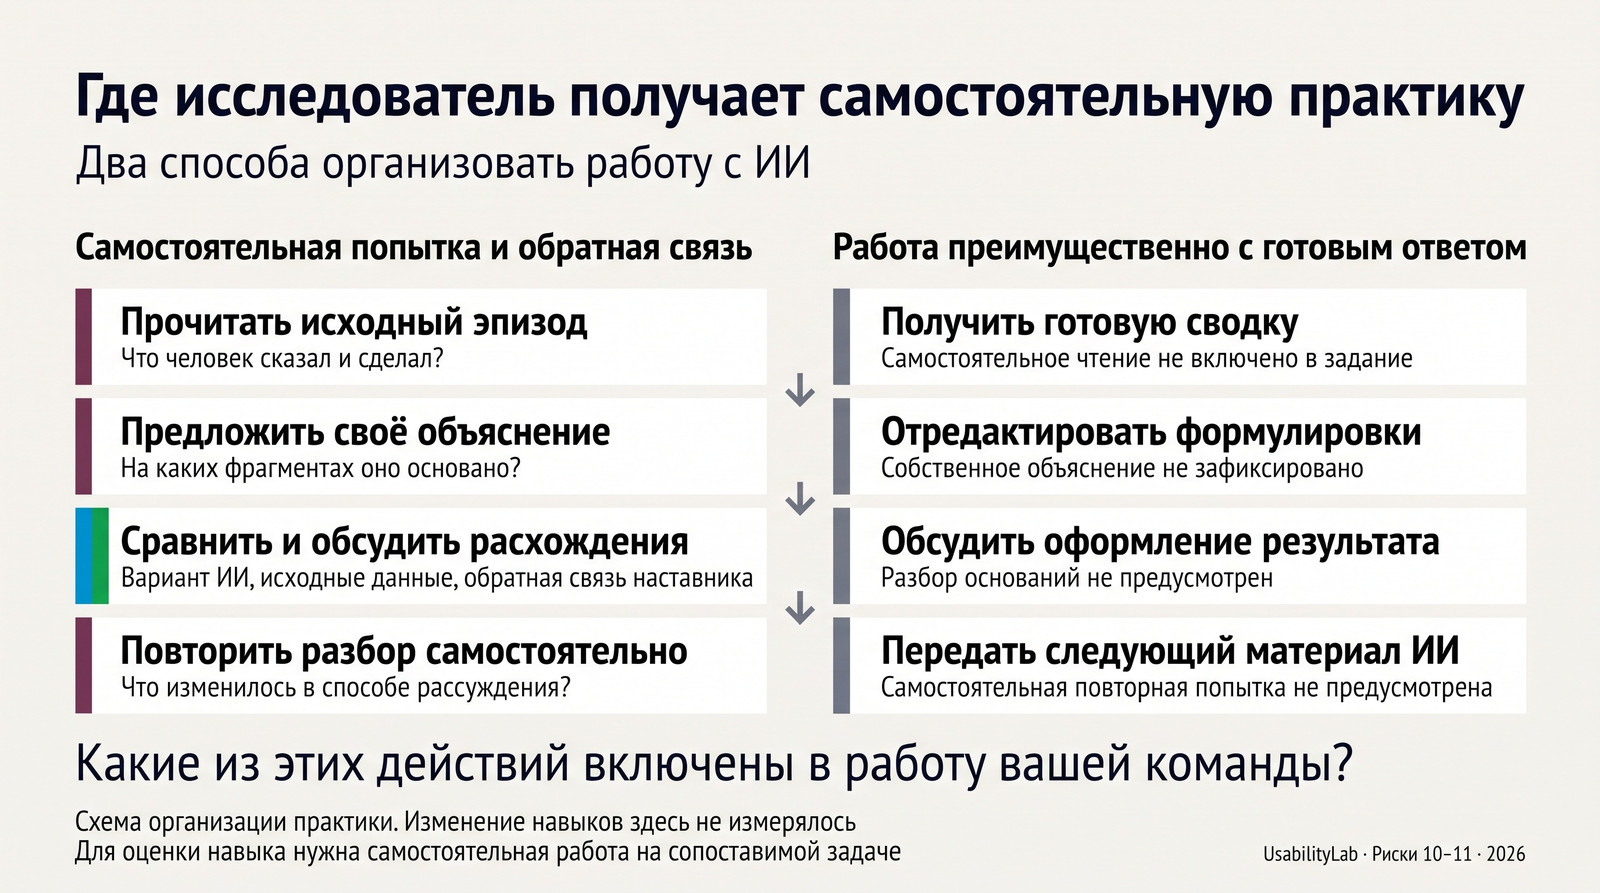
Схема дополняет риски 10–11: какие действия оставляют исследователю самостоятельную практику и обратную связь. Изменение навыков на схеме не измерялось.
12. Размывание ответственности
Когда решение принято системой «человек плюс автомат», ответственность за сбой часто ложится на ближайшего человека с ограниченным контролем. Это «моральная зона смятия» Elish 2019. В исследованиях есть два варианта. Продакт ссылается на «инсайты ИИ», хотя исследования не было. Или исследователь подписывает синтез, который не мог полностью проверить. И в том и в другом случае неясно, кто отвечает перед пользователем.
Меры контроля
- Назначенный владелец каждого вывода: человек, который видел первичные данные. Проверочный вопрос перед презентацией: «Могу ли я назвать конкретного человека, который читал транскрипт или смотрел запись?» Если нет — вывод не готов к презентации.
- Разделять в отчёте уровни: «наблюдали у людей», «вывели из данных», «предложила модель».
- Не называть исследованием разговор с моделью ни в документах, ни на гейтах.
Наблюдаемый признак. Никто не может назвать человека, который проверил основание рекомендации, либо подпись под отчётом воспринимается как подтверждение всего синтеза.
Дальнейшее действие. Назначить ответственного за конкретный вывод и дать ему доступ и время для проверки. При невозможности проверки ограничить формулировку и явно указать, что решение остаётся открытым.
Результат проверки. Перед презентацией понятны проверяющий, использованное основание и границы ответственности; факт просмотра записи не равен подтверждению интерпретации.
Сила доказательств: низкая (концептуальная рамка, применённая к исследованиям по аналогии).
Организационные и системные риски
13. Монокультура инсайтов
Если много участников рынка опираются на один алгоритм, общее качество решений может падать, даже когда алгоритм точнее каждого из них по отдельности Kleinberg, Raghavan 2021. В эксперименте с рассказами идеи от LLM сделали тексты отдельных авторов лучше, но сами тексты стали более похожи друг на друга Doshi, Hauser 2024. Это социальная дилемма. Обзор 2026 года описывает гомогенизирующее влияние LLM на выражение и мышление людей Sourati et al. 2026, а в репликациях одна модель давала почти нулевое разнообразие ответов Park et al. 2024. Для отрасли это значит, что команды, которые «исследуют» одними и теми же моделями, получат похожие инсайты и похожие продукты. Конкурентное преимущество от исследований исчезает.
Меры контроля
- Собственные первичные данные как источник отличия: то, чего нет в обучающих данных моделей.
- Разнообразие источников и методов: поле, аналитика, интервью, а не одна модель.
- Ценить в отчётах неожиданные находки, а не только подтверждения.
Наблюдаемый признак. Объяснения разных проектов почти совпадают, а локальные наблюдения и альтернативные случаи не попадают в рекомендации.
Дальнейшее действие. Сравнить основания похожих выводов, включить собственные данные и альтернативные методы. Уточнить объяснение там, где оно сглаживает контекст; необычность AI-версии сама по себе не делает её верной.
Результат проверки. Сходство рекомендаций объяснено материалом либо пересмотрено. Число тем и различие формулировок не используются как мера разнообразия знаний.
Сила доказательств: средняя (эксперименты и теория; для UX — перенос).
Этика и устойчивость
14. Данные участников и согласие
Практики качественных исследований называют защиту интересов участников одной из главных проблем при использовании LLM и указывают на острую нехватку норм Schroeder et al. 2025. В смежной области машинного обучения меньше четверти статей с человеческими данными на AAAI и NeurIPS подтверждают независимую этическую экспертизу, информированное согласие или оплату участникам McKee 2024. Для UX это три практических вопроса. Знает ли участник, что его запись будет обрабатывать внешняя модель? Куда уходят персональные данные и данные под NDA? Используются ли они для дообучения моделей поставщика? В российском контексте сюда добавляются требования к обработке и трансграничной передаче персональных данных, их стоит проверить с юристом.
Меры контроля
- Обновить форму согласия: явно назвать ИИ-обработку и её цели.
- Деперсонализировать данные до передачи во внешние сервисы, для чувствительных проектов использовать локальные или корпоративные модели.
- Проверять поставщиков ИИ-инструментов по чек-листу ESOMAR 2024.
- Внутренняя политика: какие данные и в какие инструменты можно загружать.
Наблюдаемый признак. Для выбранного сервиса неясны допустимый состав данных, условия обработки, доступ или соответствие согласованному с респондентом порядку.
Дальнейшее действие. До выяснения не передавать спорные материалы, уточнить условия у ответственных за данные и поставщика; при необходимости изменить инструмент или подготовку материала. Проверить обезличенный файл на оставшийся контекст, позволяющий узнать человека.
Результат проверки. Зафиксированы разрешённый набор данных, выбранный инструмент и ответственный за условия обработки. Локальный запуск или удаление имён не заменяют эту проверку.
Сила доказательств: средняя (нормативные и качественные работы).
15. Экологическая цена
Этот риск прямо связан с темой WUD-2026 об устойчивом будущем. По оценке бенчмарка (препринт), самые энергоёмкие модели расходуют больше 29 Вт·ч на длинный запрос, в 65 раз больше самых эффективных. Короткий запрос стоит около 0,42 Вт·ч, но в масштабе это складывается в значимые объёмы энергии, воды и выбросов Jegham et al. 2025. Тысяча синтетических респондентов, которые не заменяют десять реальных, становятся не только методической, но и экологической ошибкой. Бенчмарк пяти open-source моделей (3–9B параметров) на Apple M4 Pro показал выход: локальный деплой в 30–40 раз эффективнее по энергии на токен, чем датацентровые GPU, а модели размером 3–3,8B дают до 62% экономии на токен при сопоставимом качестве GreenBench 2026 (препринт).
Меры контроля
- Выбирать достаточную для задачи модель и обосновывать объём генерации. Перед запуском массовой генерации сравнить доступные способы выполнения на одной задаче: качество, ограничения данных, время и вычислительные затраты. Размер модели и место запуска сами по себе не гарантируют подходящего качества или меньших затрат.
- Учитывать вычислительную стоимость в плане исследования наравне с бюджетом и сроками.
Наблюдаемый признак. Массовые прогоны запускаются без проверочного задания и объяснения, как результат повлияет на работу; повторные вызовы не дают нужного улучшения.
Дальнейшее действие. Сравнить способы выполнения на ограниченном задании, учесть повторы и ручную проверку. Сократить объём или изменить способ работы, если дополнительный прогон не решает заранее обозначенную задачу.
Результат проверки. Сохранены качество результата, объём вычислений и ограничения измерения. Стоимость вызова, энергия на токен и итоговые затраты проекта оцениваются раздельно.
Сила доказательств: средняя (измерения есть, оценки сильно зависят от допущений).
Что ИИ действительно даёт
Исследования также описывают полезные сценарии применения ИИ, которые нужно оценивать с учётом задачи и условий проверки. ИИ-интервью масштабируют качественный сбор без потери тематического богатства Chopra, Haaland 2026. Тематический анализ ускоряется; согласованность AI и человека на уровне тем достигает F1=100% в лучших сессиях AlGhamdi 2026. Автоматическая обратная связь по макетам ловит тонкие ошибки Duan et al. 2024. Синтетика полезна для пилотирования инструментов Hämäläinen et al. 2023, Lin 2026. Внутри «границы возможностей» прирост производительности большой и измеренный Dell’Acqua et al. 2026, а менее опытные сотрудники выигрывают больше всех Brynjolfsson et al. 2024. Исследователи, которые уже встроены в практики ответственного ИИ, — естественные носители этих мер контроля внутри компаний Wang et al. 2023.
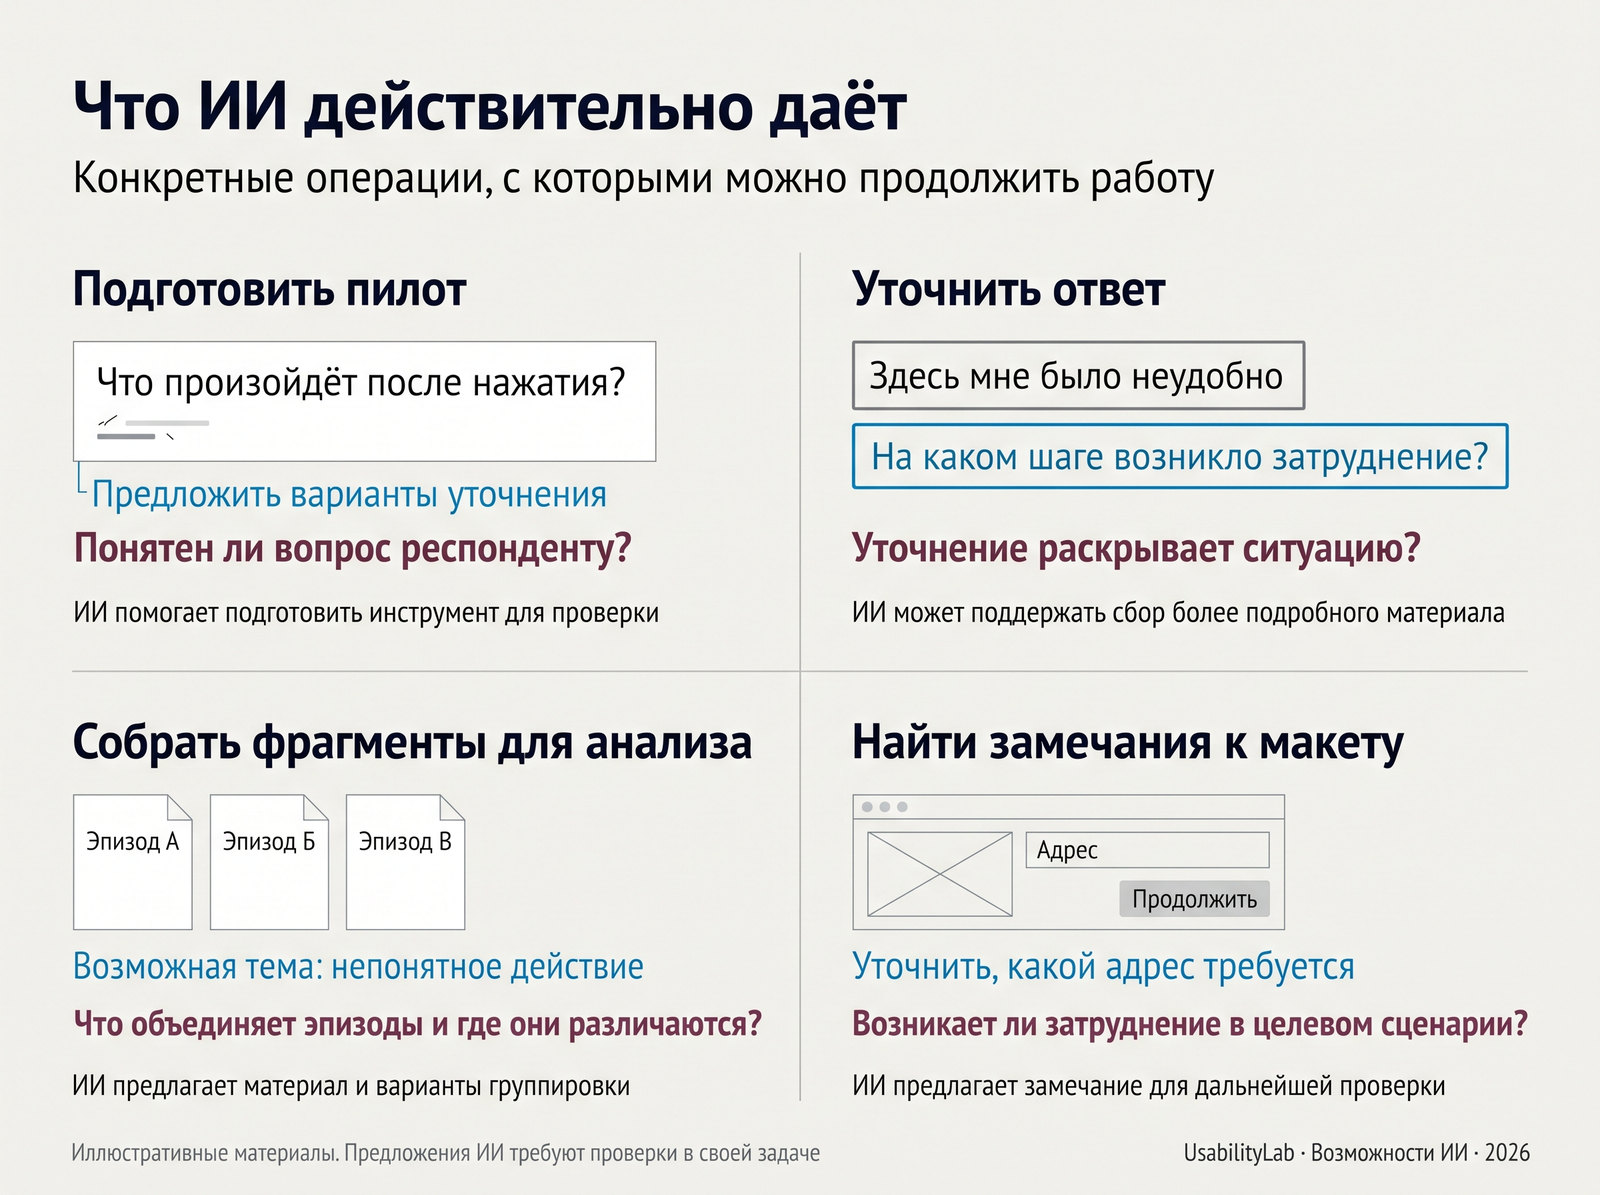
Примеры операций, результат которых можно проверить в своей задаче. Предложенная тема, уточнение или замечание к макету требуют обращения к данным и условиям исследования.
Белые пятна
Контролируемых сравнений синтетических и реальных пользователей на стандартных UX-опросниках мало, и Хиндеркс включает их в исследовательскую повестку Hinderks 2026. На русскоязычных выборках таких сравнений я не нашёл совсем. Нет данных о доле ИИ-ответов в российских онлайн-панелях. Нет прямых данных о найме джунов именно в UX-исследованиях, всё сказанное о риске 11 — перенос. Нет долгосрочных данных о том, как ИИ-модерация влияет на доверие участников к исследованиям. Нет эмпирики о том, как продуктовые команды используют ИИ-синтез при принятии решений. Опросы команд могут дополнить эту картину сведениями об организации работы; такие самоотчёты нужно отличать от наблюдения за принятием решений.